Retrouver ses photos de course par son numéro de dossard
Pendant les éditions 2025 et 2026 de la Purple Rouen, une course organisée par des étudiants, les photographes du Studio INSA ont pris des milliers de photos. Pour un coureur, retrouver les siennes dans une galerie pareille, c’est long. Et demander aux photographes de tout trier à la main ne l’est pas moins.
J’ai donc écrit une chaîne de traitement qui lit le numéro de dossard sur chaque photo. Dans la galerie, il suffit de taper son numéro pour voir ses photos.
Les étapes
Le projet tient en une douzaine de scripts Python. Chacun s’occupe d’une étape et lit sur le disque ce que l’étape précédente a produit. Tous les chemins sont centralisés dans un unique module chemins.py : pour passer des photos du photographe à celles de la photobox, ou pointer vers un nouvel entraînement, il suffit de modifier ce fichier.
| Étape | Outil | Entrée → Sortie |
|---|---|---|
| 1. Annotation | Label Studio | photos → étiquettes au format YOLO |
| 2. Entraînement | Ultralytics YOLOv8n | étiquettes → poids best.pt (6,2 Mo) |
| 3. Audit | YOLO (conf=0.70) | photos sans aucun dossard détecté → dossier de contrôle manuel |
| 4. Découpage | YOLO (conf=0.50, save_crop=True) | photos → un crop JPEG par dossard |
| 5. OCR spatial | Google Cloud Vision | crops → cache JSON (texte + coordonnées) |
| 6. Attribution | Python (règles géométriques) | cache → {photo: [dossards]} |
| 7. Publication | Pillow | dimensions + dossards → JSON pour la galerie web |
Sur l’édition 2026, il a traité deux séries : 558 photos de course (prises par le photographe, jusqu’à 6000 × 4000 px) et 160 photos de la photobox installée à l’arrivée.
Détection des dossards
Annoter les photos
Avant d’entraîner quoi que ce soit, il a fallu annoter. J’ai utilisé Label Studio pour dessiner à la main un rectangle autour de chaque dossard, exporté directement au format YOLO (une ligne classe x_centre y_centre largeur hauteur normalisée par image).
Le jeu de données final est petit, et c’est voulu :
- 126 photos annotées (67 issues de l’appareil du photographe, 59 de la sélection « Purple 2026 ») ;
- 158 boîtes au total, avec jusqu’à 8 dossards sur une même photo de groupe ;
- 23 photos sans aucun dossard, gardées comme exemples négatifs pour apprendre au modèle à ne rien détecter sur un public ou un décor.
Les dossards sont de petits objets : la boîte médiane ne fait que 9 % de la largeur et 7 % de la hauteur de l’image, soit environ 0,6 % de sa surface. Lancer un OCR directement sur la photo entière donne donc de mauvais résultats. Il vaut mieux d’abord repérer et recadrer chaque dossard.
Entraînement
J’ai pris YOLOv8n (nano), la plus petite variante, pré-entraînée sur COCO. Avec une seule classe à reconnaître et peu d’images, partir de ce modèle généraliste suffit largement. Et il est assez léger pour tout faire tourner sur CPU, sans carte graphique.
path: /chemin/vers/dataset
train: images
val: images
nc: 1
names: ['Dossard']
from ultralytics import YOLO
# On charge le modèle de base
model = YOLO("yolov8n.pt")
results = model.train(
data="data.yaml",
epochs=50,
imgsz=640,
batch=8,
device="cpu",
)Les hyperparamètres sont ceux par défaut d’Ultralytics (optimiseur automatique, lr0=0.01, 3 epochs de warmup), avec les augmentations standard : variations de teinte/saturation/luminosité, translation, mise à l’échelle et mosaic, désactivée sur les 10 dernières epochs. Les 50 epochs ont pris environ 40 minutes sur CPU.
La convergence est rapide : la mAP@50 passe de 0,19 à la première epoch à 0,90 dès la dixième, puis plafonne autour de 0,98 à partir de la vingtième.
| Epoch | Précision | Rappel | mAP@50 | mAP@50-95 |
|---|---|---|---|---|
| 1 | 0,003 | 0,804 | 0,188 | 0,116 |
| 10 | 0,908 | 0,778 | 0,896 | 0,604 |
| 20 | 0,952 | 0,943 | 0,978 | 0,663 |
| 30 | 0,987 | 0,963 | 0,984 | 0,767 |
| 45 (retenue) | 0,973 | 0,981 | 0,984 | 0,819 |
Ces chiffres sont trop beaux pour être pris au pied de la lettre. Faute de photos en nombre, j’ai utilisé le même dossier pour l’entraînement et la validation (
train: images,val: images). Ils mesurent donc à quel point le modèle a appris ces photos-là, pas s’il saura en reconnaître d’autres. La vraie validation, c’est sur les centaines de photos qu’il n’avait jamais vues qu’elle s’est faite (voir plus bas).
Inférence et recadrage
Le modèle entraîné est ensuite appliqué à toutes les photos avec l’option save_crop=True, qui enregistre directement chaque détection comme une petite image indépendante. Deux réglages comptent :
stream=True: les résultats sont produits sous forme de générateur, photo par photo, au lieu d’être tous gardés en mémoire. indispensable avec des fichiers de 24 Mpx ;- un seuil de confiance à 0,50 pour le découpage, et un seuil plus strict à 0,70 pour un script d’audit qui isole les photos où le modèle ne voit aucun dossard, afin de les vérifier à la main.
Résultat : 624 crops sur les photos de course et 251 sur la photobox.
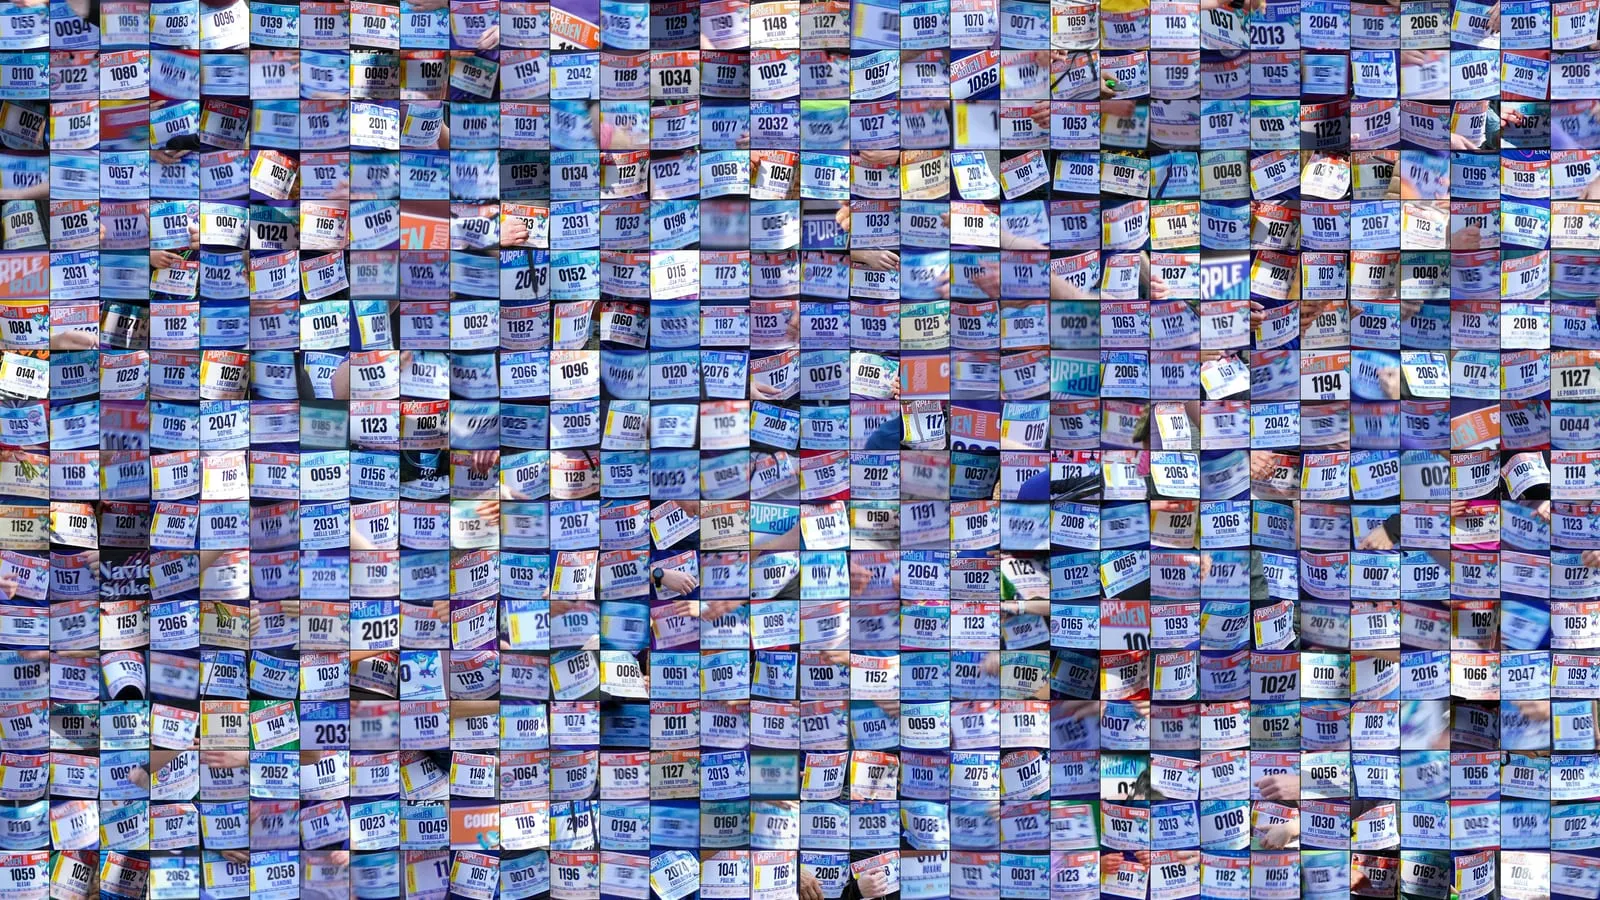
La mosaïque ci-dessus est elle-même générée par un script : les crops sont mélangés puis redimensionnés en tuiles de 128 px, sur une grille de 16k × 9k cases pour obtenir un format 16:9 exact.
Lire le texte
Pour lire le texte de ces petites images, j’utilise l’API Google Cloud Vision (text_detection). Mais lire le texte ne suffit pas : un dossard de la Purple Rouen porte bien d’autres choses que le numéro. La distance (« 5km »), l’année (« Edition 2026 »), les partenaires, un numéro de téléphone d’urgence… Sans compter la poudre colorée, marque de fabrique de la course, qui cache parfois une partie des chiffres.
Première approche : les expressions régulières
Ma première version ne gardait que le bloc de texte brut renvoyé par l’API et le nettoyait à coups de regex : suppression des numéros de téléphone (0[1-9](?:\s?\d{2}){4}), d’une liste noire des années 2000 à 2040, puis extraction des nombres de 3 ou 4 chiffres. Ça fonctionnait sur les cas simples, mais l’OCR coupe régulièrement un numéro de téléphone en plusieurs morceaux (07 83 52… devient 0783, 52…), qui passent alors à travers les filtres et sont pris pour des dossards.
Deuxième approche : garder la géométrie
Pour distinguer le numéro du reste, il faut savoir où se trouve chaque mot. Google Vision renvoie, en plus du texte complet, chaque mot avec le polygone qui l’entoure. Mon script enregistre donc dans un fichier JSON les coordonnées et la hauteur en pixels de chaque mot :
for word in texts[1:]:  # texts[0] contient le bloc complet
    xs = [getattr(v, "x", 0) for v in word.bounding_poly.vertices]
    ys = [getattr(v, "y", 0) for v in word.bounding_poly.vertices]
    mots.append({
        "texte": word.description,
        "hauteur": max(ys) - min(ys),
        "x_min": min(xs), "x_max": max(xs),
        "y_min": min(ys), "y_max": max(ys),
    })
Le getattr(v, "x", 0) est nécessaire : le format protobuf de l’API omet les champs égaux à zéro, donc un mot collé au bord gauche ou supérieur du crop arrive sans coordonnée x ou y.
Chaque crop produit une entrée de ce type dans le cache (exemple simplifié) :
"Purple_2026_042-2.jpg": {
    "texte_complet": "PURPLE\nCourse\n1234\nURGENCE 06 12 34 56 78\n...",
    "mots_individuels": [
        { "texte": "PURPLE", "hauteur": 76, "y_min": 33, ... },
        { "texte": "1234",   "hauteur": 81, "y_min": 127, ... },
        { "texte": "06",     "hauteur": 11, "y_min": 140, ... }
    ]
}
Sur les 624 crops de la course, l’API a lu 3 313 mots ; 47 crops n’ont renvoyé aucun texte (dossard flou, de biais ou recouvert de poudre).
Trouver le bon nombre
Comme les réponses brutes de Google Vision sont gardées dans un cache JSON, j’ai pu essayer et corriger mes règles autant de fois que nécessaire sans rappeler (ni payer) l’API. Avec moins de 900 crops au total, le pipeline reste de toute façon dans l’ordre de grandeur du palier gratuit de l’API (1 000 requêtes par mois), à condition de ne pas relancer l’OCR à chaque essai.
Pour retrouver le numéro parmi tous les mots lus, j’ai fini par n’utiliser que la géométrie, en trois étapes :
# A. Ne garder que les mots composés strictement de 3 ou 4 chiffres
candidats = [m for m in mots if re.fullmatch(r"\d{3,4}", m["texte"])]

# B. Éliminer le texte écrit trop petit (< 50 % du plus grand candidat)
h_max = max(c["hauteur"] for c in candidats)
gros = [c for c in candidats if c["hauteur"] >= h_max * 0.5]

# C. Garder le plus haut sur le dossard (y_min minimal)
vainqueur = min(gros, key=lambda c: c["y_min"])
L’étape B filtre d’un coup les mentions du type “Edition 2026” ou les morceaux de numéros de téléphone, imprimés en petit. Le seuil est relatif (50 % de la hauteur maximale) plutôt que fixe, car la taille d’un crop varie énormément selon que le coureur est au premier plan ou au fond de la photo. Parmi les nombres qui restent, on garde celui dont la coordonnée Y est la plus haute sur l’image : c’est en général le numéro porté sur la poitrine, au-dessus du reste.
Sur la course, cette règle n’a vraiment eu à trancher que pour 68 crops qui avaient plusieurs candidats ; 81 crops n’en contenaient aucun et ont été écartés.
Le script regroupe ensuite les numéros trouvés sur les différents crops sous le nom de l’image originale. Ultralytics nomme les découpes successives d’une même photo photo.jpg, photo-2.jpg, photo-3.jpg… : une regex (-\d+(?=\.[a-zA-Z0-9]+$)) retire ce suffixe, puis les dossards sont dédoublonnés et triés.
{
    "Purple_2026_042.jpg": ["0102", "0167"],
    "Purple_2026_043.jpg": []
}
Publier dans la galerie
Dernière étape : le site photos.purplerouen.fr a besoin, pour chaque photo, de son nom, de ses dimensions (afin de réserver la place dans la grille avant chargement et éviter les sauts de mise en page) et de sa liste de dossards. Pillow lit les dimensions sans décoder l’image entière, ce qui rend l’export quasi instantané :
{ "name": "Purple_2026_042.jpg", "width": 3672, "height": 4896, "dossards": ["0102", "0167"] }Une photo sans dossard reste dans la galerie avec un tableau vide : elle n’est simplement pas indexée pour la recherche.
Résultats
| Course | Photobox | |
|---|---|---|
| Photos publiées | 558 | 160 |
| Crops détectés par YOLO | 624 | 251 |
| Photos avec au moins un dossard identifié | 356 (64 %) | 96 (60 %) |
| Photos avec plusieurs dossards | 87 | 68 |
| Numéros de dossard distincts | 304 | 132 |
Au total, 349 coureurs différents peuvent retrouver leurs photos en tapant leur numéro, avec en moyenne deux photos par dossard et jusqu’à neuf pour les plus photogéniques. Les photos non indexées sont pour l’essentiel des plans larges, des photos de public, ou des coureurs de dos : il n’y a tout simplement pas de dossard lisible.
En bonus, un GIF par coureur
Une fois qu’on sait quelles photos vont avec quel dossard, faire un souvenir personnalisé devient facile. Un dernier script relit les fichiers structure.json publiés par la galerie (course + photobox), sélectionne jusqu’à 10 photos par dossard, corrige leur orientation EXIF, les recadre en 640 × 480 sans déformation (ImageOps.fit) et les assemble en GIF animé à 0,8 seconde par image, un format léger et lisible directement dans un mail.
336 GIF ont été générés de cette façon.
Données personnelles
Les caches OCR contiennent, en clair, les numéros de téléphone d’urgence imprimés au dos ou au bas des dossards. Le dépôt ne versionne donc que le code, les annotations et les poids du modèle ; photos, crops et résultats OCR restent en local, et la clé de service Google Cloud est stockée en dehors du projet.
Ce que j’en retiens
Sur les deux éditions, plus de 1 200 dossards ont été indexés, et les photographes n’ont rien eu à trier.
- Un petit modèle bien ciblé suffit. 126 photos annotées et 40 minutes de CPU ont donné un détecteur utilisable en vrai.
- Recadrer avant de lire. YOLO trouve le dossard, l’OCR lit le numéro : chacun fait ce qu’il sait faire.
- Garder les réponses brutes. Grâce au cache, je suis passé des regex à la géométrie sans payer une seule requête de plus.
Ce qui manque encore, c’est un vrai jeu de validation séparé, pour mesurer honnêtement la précision de bout en bout, de la photo au numéro attribué.